
Banyak Pemeringkat Mesin Pencari GSA pengguna juga memiliki salinan XRumer. Beberapa membelinya bertahun-tahun yang lalu, dan banyak yang mendapatkannya karena fitur pemecah captcha XEvil yang disertakan. Sebagian besar dari mereka tidak pernah menggunakan alat XRumer lainnya, yang sangat disayangkan, karena salah satunya sangat bagus dalam menemukan target baru untuk GSA SER.
Alat itu adalah Analisis Pola Tautan. Program ini membaca daftar URL yang sudah Anda posting dan mengambil pola URL yang mereka miliki bersama. Pola-pola tersebut menjadi jejak yang dapat Anda gunakan untuk melakukan scraping, sehingga Anda dapat menemukan lebih banyak situs yang menggunakan platform yang sama. Saya pertama kali menulis panduan ini pada tahun 2019 dan memperbaruinya pada Oktober 2026, termasuk perubahan yang terjadi dalam proses scraping Google sejak saat itu.
Jawaban singkat: temukan jejak GSA SER dengan XRumer
- Gunakan nomor SER GSA Anda. terverifikasi Daftar tersebut sebagai sumber, karena GSA SER telah memposting ke situs-situs tersebut.
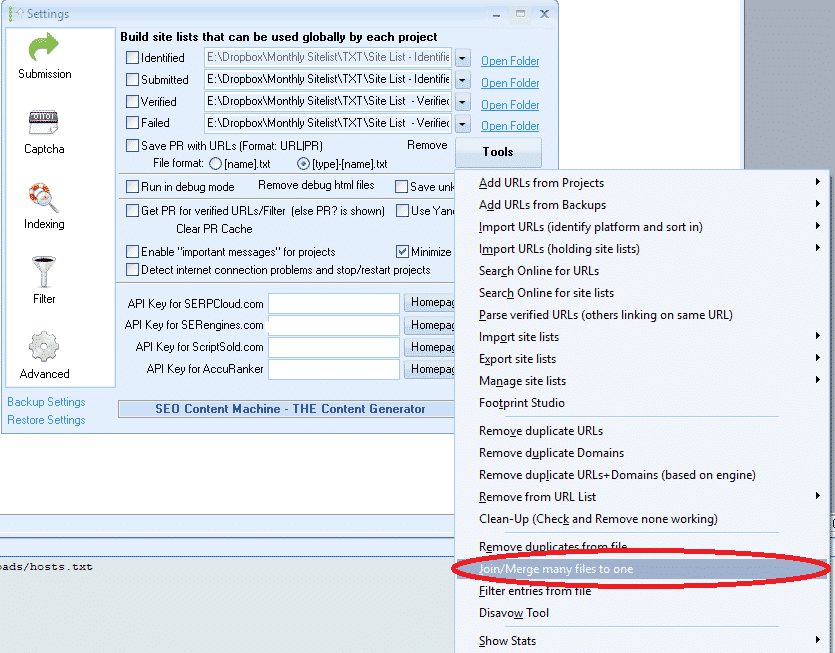
- Di GSA SER, gabungkan berkas yang telah diverifikasi menjadi satu berkas dan hapus domain yang duplikat.
- Di XRumer, buka Alat > Analisis Pola Tautan, muat file, atur Cakupan Analisis ke /nama file dan Format Laporan untuk Google “inurl”.
- Batasi laporan hingga 1.000 hasil, klik Mulai, lalu salin tab Teks ke dalam file jejak.
- Di Scrapebox, gabungkan jejak digital dengan kata kunci niche Anda dan kumpulkan data, terutama dari Bing dan Google.
- Impor URL yang telah di-scrape ke dalam GSA SER dan biarkan sistem tersebut mengidentifikasi platformnya.
Apa itu jejak kaki (footprint) di GSA SER?
Jejak (footprint) adalah sepotong teks atau pola URL yang dimiliki setiap situs di platform tertentu. Situs WordPress, misalnya, biasanya menampilkan "Powered by WordPress" di footer kecuali pemiliknya menghapusnya, dan halamannya menggunakan jalur seperti... /wp-login.php. Setiap sistem manajemen konten meninggalkan jejak seperti ini pada URL, judul halaman, atau kontennya.
Saat Anda melakukan scraping untuk target, Anda menggabungkan jejak digital dengan kata kunci dan mengirimkannya ke mesin pencari. Mesin pencari akan mengembalikan situs yang cocok, dan situs-situs itulah yang mungkin dapat diakses oleh GSA SER. GSA SER sudah memiliki jejak digital untuk setiap mesin pencari yang didukungnya, tetapi daftar yang dibuat dari situs terverifikasi Anda sendiri sering kali menemukan platform dan pola URL yang terlewatkan oleh jejak digital bawaan.
Operator pencarian apa yang Anda butuhkan?
| Operator | Apa yang ditemukannya | Contoh |
|---|---|---|
inurl: | Halaman yang memiliki kata atau jalur di URL. | inurl:apple |
judul: | Halaman yang memiliki sebuah kata dalam judul halaman | judul:apel |
lokasi: | Halaman dari satu domain atau TLD | situs:apple.com |
Ketiganya masih bekerja di Google pada tahun 2026, menurut daftar Ahrefs. Operator pencarian Google (diperbarui Agustus 2026). Beberapa operator lama, seperti cache:, link: Dan info:, tidak lagi berfungsi. Tidak semua mesin pencari memahaminya. inurl:, yang akan menjadi penting nanti saat Anda melakukan scraping.
Bagaimana cara Anda mempersiapkan daftar GSA SER Anda untuk ekstraksi jejak (footprint)?
Mulailah dengan Anda daftar situs terverifikasi. Ini adalah situs-situs yang tautannya sudah dibuat oleh GSA SER, sehingga jejak yang diambil dari situs-situs tersebut mengarah ke situs-situs yang dapat digunakan untuk memposting.
- Hanya satu platform: Gunakan satu file dari folder yang sudah diverifikasi. Untuk situs artikel WordPress, yaitu...
sitelist_Article-Artikel WordPress. Untuk situs MediaWiki, caranya adalah...sitelist_Wiki-MediaWiki. - Semua platform: Gabungkan semua berkas yang telah diverifikasi menjadi satu berkas, lalu hapus domain yang duplikat.
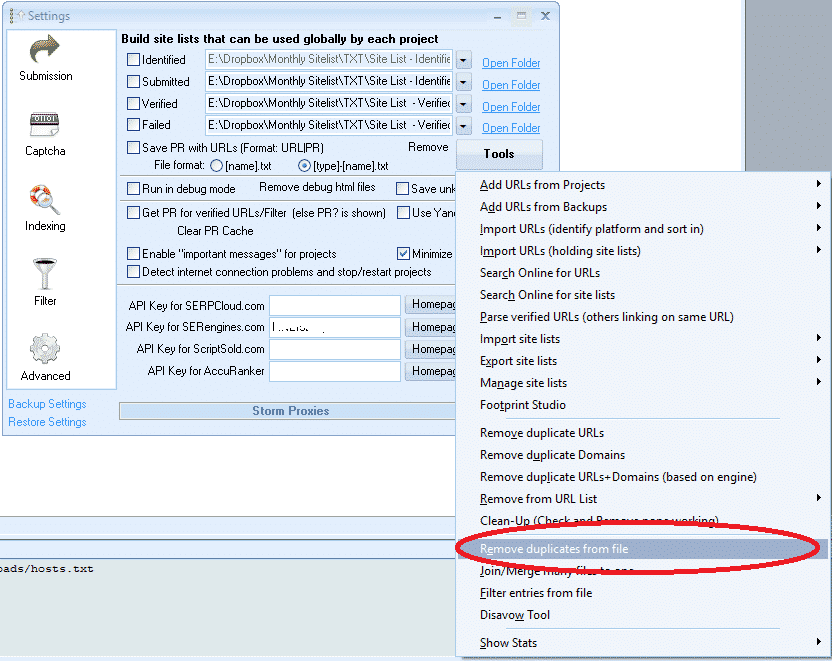
GSA SER memiliki alat untuk kedua langkah tersebut. Kunjungi Opsi > Lanjutan > Alat dan menggunakan Menggabungkan banyak file menjadi satu., Kemudian Hapus domain duplikat dari file.. Video di atas menunjukkan keduanya.
Jika Anda belum memiliki daftar terverifikasi sendiri, kami Daftar tautan terverifikasi GSA SER Saat ini, data tersebut memuat 92.393.047 URL yang teridentifikasi dan diperbarui sekali sehari, yang memberi Anda sumber data yang besar untuk mengekstrak jejak digital.
Bagaimana cara mengekstrak jejak kaki dengan Analisis Pola XRumer Links?
- Di menu XRumer, buka Peralatan.
- Memilih Analisis Pola Tautan.
- Di bagian atas layar, telusuri daftar yang telah Anda siapkan di GSA SER.
- Mengatur Lingkup Analisis ke /nama file. Ini memberikan hasil yang paling banyak. Cobalah juga alat ukur lainnya setelahnya, karena alat ukur tersebut menemukan pola yang berbeda.
- Mengatur Format Laporan ke Google “inurl”.
- Dari keempat kotak centang di bawah ini, centang hanya Batasi laporan untuk dan biarkan tetap pada 1.000 hasil.
- Klik Awal.
- Setelah selesai, buka TXT tab (di sebelah TABEL dan BAGAN).
- Pilih dan salin semua hasilnya, tempelkan ke dalam file teks, lalu simpan.
- Periksa file tersebut dan hapus jejak yang tidak Anda inginkan, seperti kata kunci biasa. Jika Anda tidak yakin, biarkan saja.

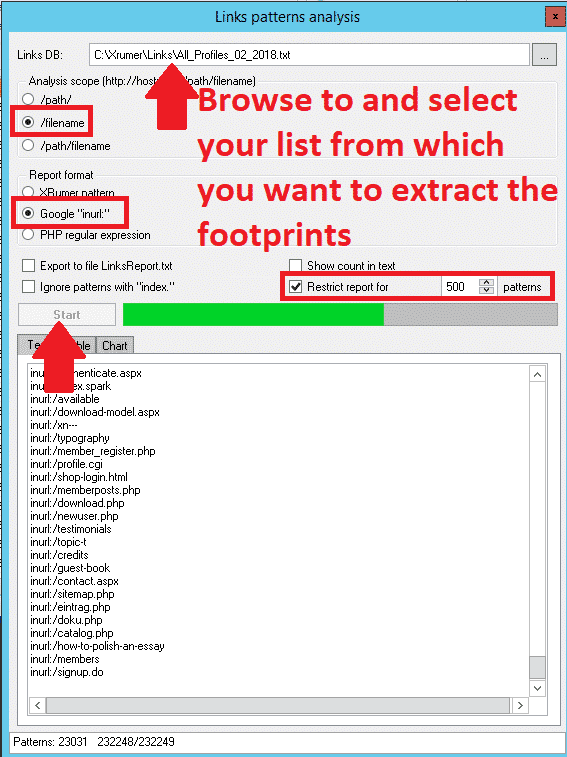
Tangkapan layar ini berasal dari versi XRumer yang saya gunakan pada tahun 2019. Versi saat ini adalah XRumer 23, dan saya belum memeriksa ulang apakah label menu telah berpindah, jadi carilah alat yang sama di bawah Tools jika tampilan layar Anda berbeda.
Bagaimana cara agar jejak digital tersebut berfungsi di mesin pencari lain?
Google memahaminya inurl:, Namun, beberapa mesin pencari lain tidak. Jika Anda hanya melakukan scraping pada Google, biarkan file tersebut apa adanya. Jika Anda juga melakukan scraping pada mesin pencari lain, buat salinan file tersebut dan hapus operatornya:
- Buka salinannya di Notepad dan pilih Edit > Ganti.
- Dalam Temukan apa, memasuki
inurl:. - Meninggalkan Ganti dengan kosong dan klik Ganti Semua.
Gunakan salinan tersebut untuk mesin pencari selain Google, atau tempel kembali ke file asli jika Anda ingin menjalankan satu proses pengambilan data dengan kedua versi tersebut.
Bagaimana cara melakukan scraping dengan footprint baru di Scrapebox?
Scrapebox masih menjadi alat pengumpul data termudah untuk ini. Versi saat ini adalah 2.1.57 (Januari 2026), dijual sebagai pembelian sekali bayar.
- Di jendela utama Scrapebox, pilih Jejak Kustom.
- Masukkan kata kunci Anda atau impor dari file. Gunakan kata kunci yang terkait dengan niche Anda. Semakin banyak kata kunci yang Anda tambahkan, semakin lama proses scraping berlangsung. Kami layanan pengikis kata kunci dapat membuat daftar kata kunci khusus yang besar untuk Anda.
- Klik M tombol untuk menggabungkan file footprint Anda dengan kata kunci.
- Klik Mulai Panen.
- Pilih mesin pencari. Saya mulai dengan Bing dan Google, karena keduanya memberikan hasil terbanyak.
- Di atas mesin pemanen Proksi tab, centang Aktifkan pemuatan otomatis (dari file) lalu pilih file proxy Anda.
- Klik Awal.
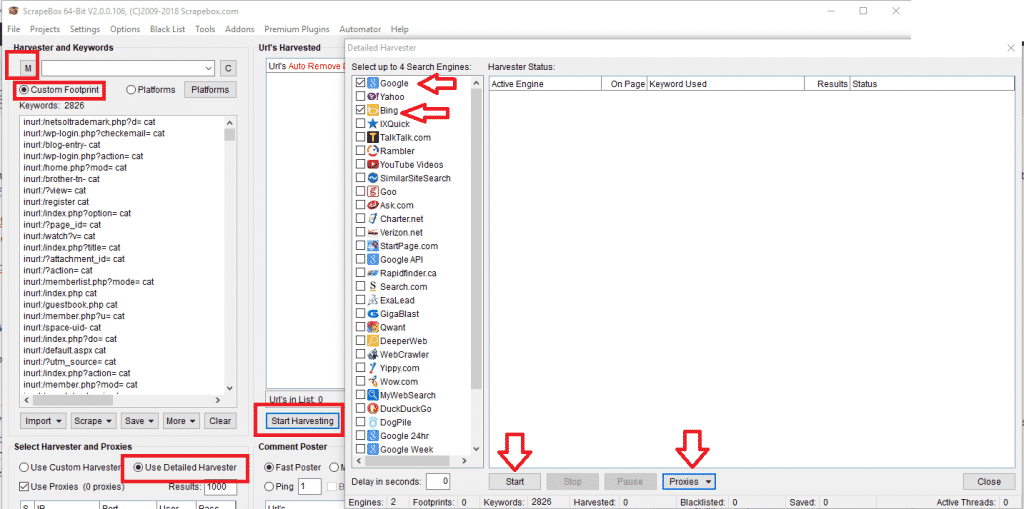
Untuk detail lebih lanjut mengenai mesin pemanen, lihat Pertanyaan Umum tentang Pemanen Scrapebox.
Mengapa pengambilan data dari Google (scraping) lebih sulit di tahun 2026?
Dua perubahan sejak panduan ini pertama kali ditulis membuat Google lebih lambat dalam melakukan scraping:
- Persyaratan JavaScript: Sejak Januari 2025, Google meminta pengunjung untuk mengaktifkan JavaScript agar dapat menggunakan Pencarian. Seorang juru bicara Google mengatakan kepada TechCrunch bahwa hal ini dimaksudkan untuk melindungi Pencarian dari bot dan spam dengan lebih baik. Scraper sederhana yang tidak menjalankan JavaScript kini lebih sering gagal.
- Tidak ada lagi 100 hasil per halaman: Pada bulan September 2025, Google berhenti mendukungnya.
&num=100parameter, sehingga scraper membutuhkan sepuluh permintaan untuk mendapatkan 100 hasil, bukan hanya satu.
Dalam praktiknya, itu berarti lebih banyak proxy, lebih banyak kueri yang gagal, dan pengumpulan data Google yang lebih lambat. Bing dan mesin pencari lain yang didukung Scrapebox seringkali menjadi sumber volume yang lebih baik saat ini. Proxy pribadi yang baik lebih penting dari sebelumnya: lihat panduan kami. layanan proksi.
Apa yang Anda lakukan dengan URL yang telah di-scrape?
Hapus domain duplikat di Scrapebox, lalu impor daftar tersebut ke GSA SER. Anda dapat mengimpornya langsung ke dalam proyek sebagai URL target, atau menggunakan Opsi > Lanjutan > Alat > Impor URL (identifikasi platform dan urutkan) Jadi, GSA SER mengurutkannya ke dalam daftar yang Anda identifikasi berdasarkan platform. Jalankan melalui sebuah proyek dan yang berhasil akan masuk ke dalam daftar terverifikasi Anda, yang kemudian dapat Anda masukkan kembali ke XRumer untuk putaran berikutnya.
Jika Anda lebih memilih untuk tidak menggaruk diri sendiri, kami layanan pengikis URL target melakukannya untuk Anda.
Pertanyaan yang sering diajukan
Apa itu jejak digital (footprint) di GSA Search Engine Ranker?
Jejak (footprint) adalah teks atau pola URL yang digunakan bersama oleh setiap situs di suatu platform, seperti jalur dalam URL atau baris dalam footer. Dikombinasikan dengan kata kunci di mesin pencari, jejak tersebut menemukan situs-situs baru yang dapat digunakan GSA SER untuk memposting.
Daftar mana yang harus saya gunakan untuk mengekstrak footprint?
Gunakan daftar terverifikasi Anda. GSA SER telah membuat tautan di situs-situs tersebut, sehingga pola yang ditemukan XRumer di dalamnya mengarah ke situs yang dapat digunakan untuk memposting. Gabungkan file dan hapus domain duplikat terlebih dahulu.
Pengaturan XRumer mana yang harus saya gunakan untuk Analisis Pola Tautan?
Atur Cakupan Analisis ke /namafile, Format Laporan ke Google inurl, dan centang hanya Batasi laporan untuk, pada 1.000 hasil. Kemudian salin hasil dari tab TXT ke dalam file teks.
Apakah operator pencarian Google seperti inurl: masih berfungsi?
Ya. inurl:, intitle: dan site: masih berfungsi di Google pada tahun 2026. Operator lama seperti cache:, link: dan info: tidak lagi berfungsi, dan beberapa mesin pencari lain tidak memahami inurl:.
Mengapa Scrapebox mendapatkan lebih sedikit hasil pencarian di Google sekarang?
Sejak Januari 2025, Google mewajibkan JavaScript untuk menggunakan Pencarian, dan pada September 2025 mereka menghapus opsi untuk menampilkan 100 hasil per halaman. Scraper membutuhkan lebih banyak proxy dan lebih banyak permintaan, sehingga Bing dan mesin pencari lainnya seringkali menjadi sumber volume yang lebih baik.
Apakah saya memerlukan XRumer untuk menemukan footprint GSA SER?
Tidak. GSA SER memiliki jejak (footprint) sendiri untuk setiap mesin yang didukungnya. XRumer berguna karena menemukan pola URL tambahan di situs terverifikasi Anda sendiri, yang sering kali menemukan target yang terlewatkan oleh jejak bawaan.
Semakin banyak target berarti semakin banyak tautan terverifikasi. Dapatkan daftar tautan terverifikasi kami untuk mengekstrak jejak, atau biarkan kami mengumpulkan target baru untuk Anda.

 English
 简体中文
 Deutsch (Sie)
 Bahasa Indonesia
 Italiano
 日本語
 한국어
 Português do Brasil
 Русский
 Español de México
 ไทย
 Tiếng Việt
 Türkçe