
许多 GSA 搜索引擎排名器 用户还拥有以下副本: XRumer. 有些人几年前就买了XRumer,很多人买它是为了用它自带的XEvil验证码破解器。可惜的是,他们中的大多数人从未用过XRumer的其他工具,因为其中一个工具非常擅长寻找GSA SER的新目标。.
那个工具是 链接模式分析. 它会读取你已发布内容的 URL 列表,并提取它们共有的 URL 模式。这些模式会成为你可以抓取的痕迹,从而帮助你找到更多使用相同平台的网站。我最初在 2019 年撰写了本指南,并在 2026 年 10 月进行了更新,包括自那时以来 Google 抓取技术的变化。.
简答:使用 XRumer 查找 GSA SER 封装
- 请使用您的 GSA SER 已验证 将其列为来源,因为 GSA SER 已经在这些网站上发布了信息。.
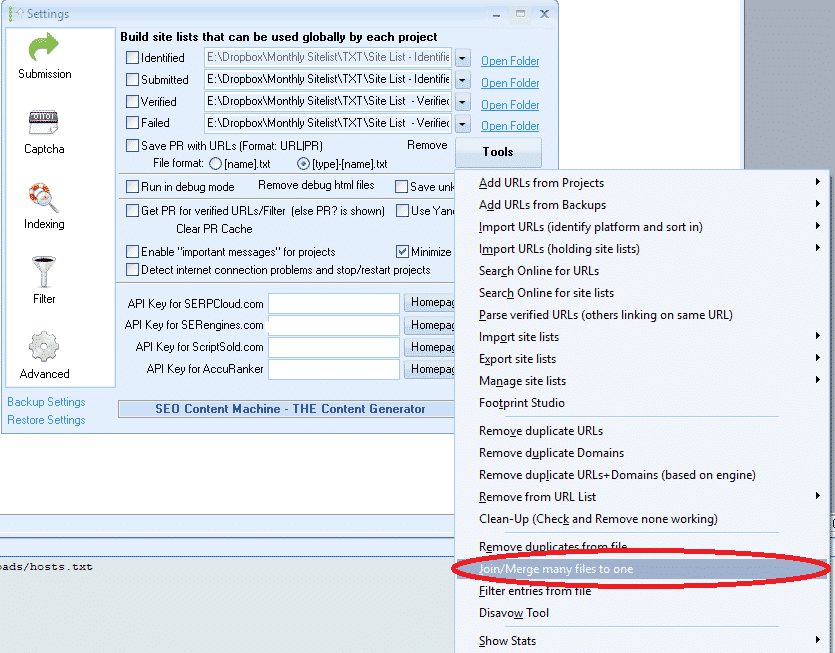
- 在 GSA SER 中,将已验证的文件合并为一个文件,并删除重复的域。.
- 在 XRumer 中,打开 工具 > 链接模式分析, 加载文件,设置分析范围为 /文件名 以及报告格式 Google “inurl”.
- 将报告结果限制为 1,000 条,单击“开始”,然后将“文本”选项卡复制到“足迹”文件中。.
- 在 Scrapebox 中,将这些足迹与你的利基关键词合并,并主要从 Bing 和 Google 收集数据。.
- 将抓取的 URL 导入 GSA SER,让它识别平台。.
GSA SER 中的足迹是什么?
网站足迹是指特定平台上所有网站共享的一段文本或URL模式。例如,WordPress网站通常会在页脚显示“Powered by WordPress”(除非所有者将其删除),其页面路径也类似如下: /wp-login.php. 每个内容管理系统都会在其 URL、页面标题或内容中留下类似的痕迹。.
当您抓取目标网站时,需要将网站特征与关键词结合起来,然后发送到搜索引擎。搜索引擎会返回匹配的网站,而这些网站正是 GSA SER 可以发布内容的网站。GSA SER 已经拥有其支持的每个搜索引擎的网站特征,但您自己验证过的网站列表通常可以找到默认网站特征所遗漏的平台和 URL 模式。.
你需要哪些搜索运算符?
| 操作员 | 它发现了什么 | 例子 |
|---|---|---|
inurl: | URL中包含特定单词或路径的页面 | 网址:苹果 |
标题: | 页面标题中包含某个单词的页面 | 标题:苹果 |
地点: | 来自同一域名或顶级域名的页面 | 网站:apple.com |
根据Ahrefs的列表,这三人到2026年仍将在谷歌工作。 Google 搜索运算符 (2026年8月更新)。一些较老的运营商,例如: 缓存:, 关联: 和 信息:, 不再有效。并非所有搜索引擎都理解。 inurl:, 这在之后的刮削过程中很重要。.
如何准备用于提取足迹的 GSA SER 列表?
从你的 已验证网站列表. 这些网站是 GSA SER 已经建立链接的网站,因此从这些网站上获取的信息指向它可以发布内容的网站。.
- 仅限一个平台: 使用已验证文件夹中的单个文件。对于 WordPress 文章网站来说,就是如此。
网站列表_文章-WordPress文章. 对于 MediaWiki 站点来说,它是网站列表_维基媒体维基. - 所有平台: 将所有已验证的文件合并成一个文件,然后删除重复的域名。.
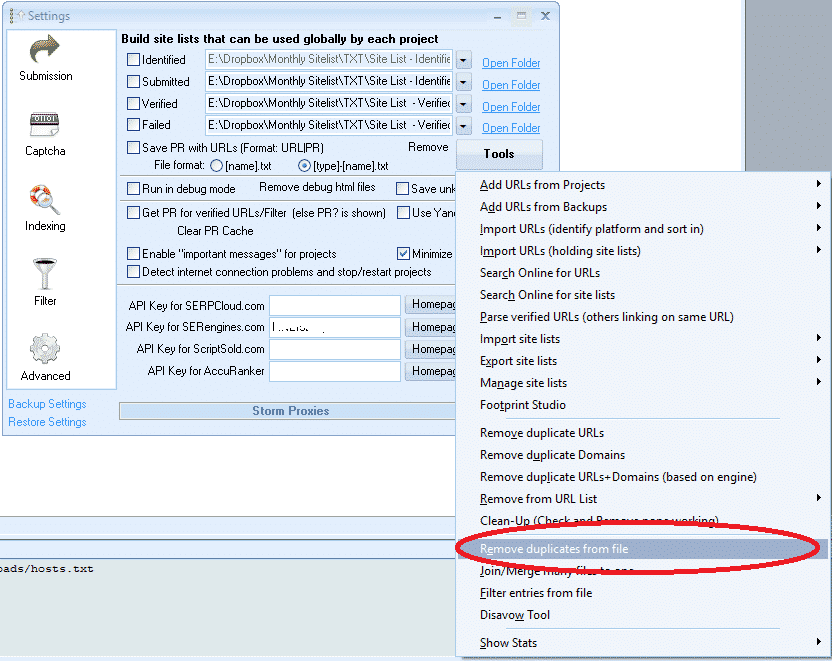
GSA SER 提供了完成这两个步骤所需的工具。请前往 选项 > 高级 > 工具 并使用 将多个文件合并为一个文件, , 然后 从文件中删除重复的域名. 上面的视频展示了这两点。.
如果您还没有自己的已验证列表,我们的 GSA SER 已验证链接列表 目前已识别出 92,393,047 个 URL,并且每天更新一次,这为您提供了一个庞大的资源来提取足迹。.
如何使用 XRumer Links Pattern Analysis 提取足迹?
- 在 XRumer 菜单中,打开 工具.
- 选择 链接模式分析.
- 在屏幕顶部,浏览到您在 GSA SER 中准备的列表。.
- 放 分析范围 到 /文件名. 这样能得到最多的结果。之后也试试其他范围,因为它们会发现不同的模式。.
- 放 报告格式 到 Google “inurl”.
- 以下四个复选框中,仅勾选一个。 限制报告 并将结果数限制在 1000 条。.
- 点击 开始.
- 完成后,打开 TXT 选项卡(位于表格和图表旁边)。.
- 选择并复制所有结果,将其粘贴到文本文件中并保存。.
- 浏览文件,删除不需要的痕迹,例如简单的关键词。如果不确定,可以保留。.

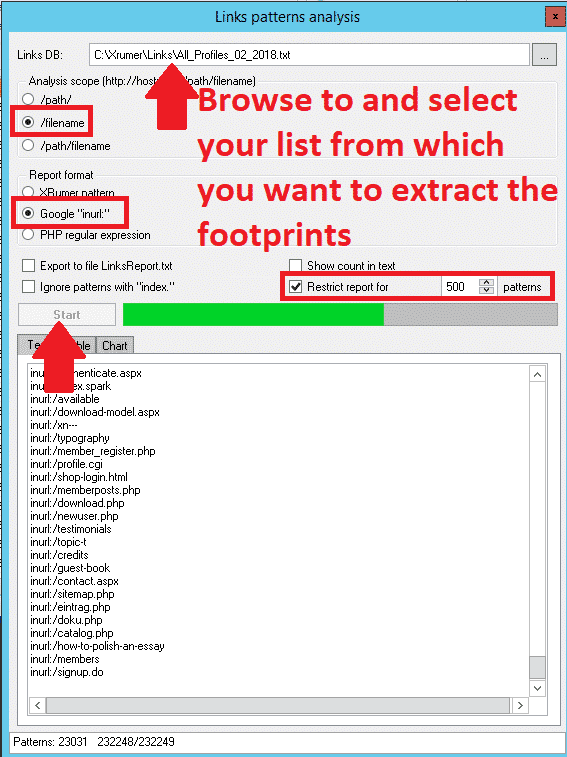
这些截图来自我 2019 年使用的 XRumer 版本。当前版本是 XRumer 23,我还没有重新检查菜单标签是否已移动,因此如果您的屏幕看起来不同,请在“工具”菜单下查找相同的工具。.
如何让这些足迹在其他搜索引擎上也能正常工作?
谷歌明白 inurl:, 但其他一些搜索引擎则不然。如果您只抓取 Google 的数据,请保持文件原样。如果您还抓取其他搜索引擎的数据,请复制该文件并删除其中的运算符:
- 在记事本中打开副本并选择 编辑 > 替换.
- 在 找到什么, , 进入
inurl:. - 离开 替换为 清空并点击 全部替换.
对于非谷歌搜索引擎,请使用该副本;如果您想使用两个版本运行一次抓取,请将其粘贴回原始文件中。.
如何使用 Scrapebox 中的新足迹进行数据抓取?
Scrapebox 仍然是最简便的采集器。当前版本为 2.1.57(2026 年 1 月),一次性购买即可使用。.
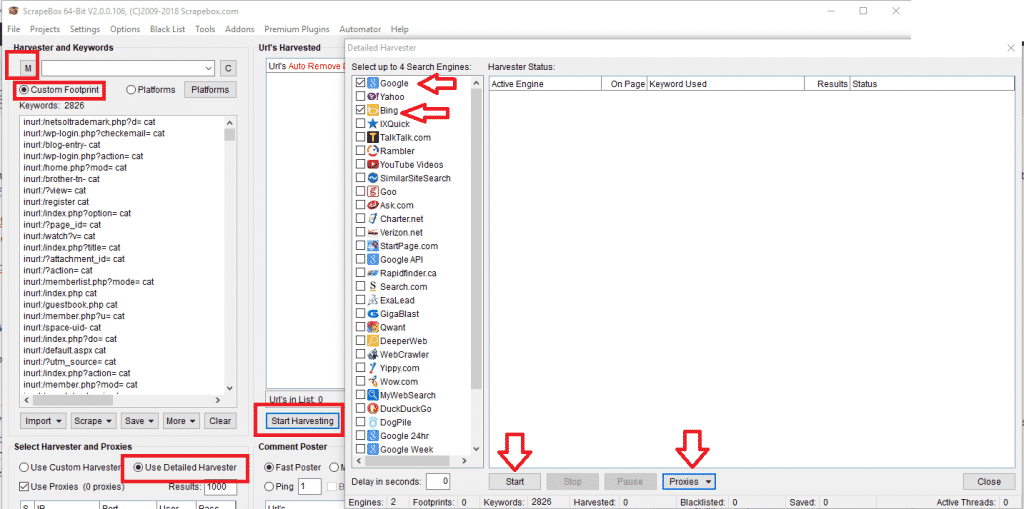
- 在 Scrapebox 主窗口中,选择 定制足迹.
- 输入关键词或从文件中导入。请使用与您所在领域相关的关键词。添加的关键词越多,抓取所需时间越长。 关键词抓取服务 可以为您构建一个庞大的利基关键词列表。.
- 点击 M 按下此按钮,即可将您的足迹文件与关键词合并。.
- 点击 开始收割.
- 选择搜索引擎。我通常先用必应和谷歌,因为它们返回的结果最多。.
- 在收割机上 代理 标签页,勾号 启用自动加载(从文件加载) 并选择您的代理文件。.
- 点击 开始.
有关收割机的更多详细信息,请参阅 刮土箱收割机常见问题解答.
为什么到 2026 年抓取 Google 数据会更难?
自本指南首次编写以来,两项变更导致 Google 抓取数据的速度变慢:
- JavaScript 要求: 自 2025 年 1 月起,谷歌要求用户启用 JavaScript 才能使用搜索功能。谷歌发言人告诉 TechCrunch,此举旨在更好地保护搜索功能免受机器人和垃圾邮件的侵害。现在,不运行 JavaScript 的简单爬虫程序更容易失效。.
- 每页不再显示 100 条结果: 2025年9月,谷歌停止了对该产品的支持。
&num=100参数,因此爬虫需要十次请求才能获得 100 个结果,而不是一次。.
实际上,这意味着需要更多代理、更多查询失败以及更慢的 Google 数据抓取速度。Bing 和 Scrapebox 支持的其他搜索引擎现在通常是更好的流量来源。优质的私有代理比以往任何时候都更加重要:请参阅我们的 代理服务.
你如何处理抓取到的URL?
在 Scrapebox 中删除重复域名,然后将列表导入 GSA SER。您可以直接将其作为目标 URL 导入到项目中,或者使用 选项 > 高级 > 工具 > 导入网址(识别平台并排序) 因此,GSA SER 会根据平台将它们分类到您已识别的列表中。将它们应用到项目中,成功的平台最终会进入您的已验证列表,然后您可以将该列表反馈给 XRumer 以进行下一轮筛选。.
如果您不想刮伤自己,我们的 目标URL抓取服务 它会为你完成。.
常见问题解答
GSA搜索引擎排名器中的“足迹”是什么?
网站足迹是指平台上所有网站共享的文本或 URL 模式,例如 URL 中的路径或页脚中的一行。结合搜索引擎中的关键词,网站足迹可以帮助 GSA SER 找到可以发布内容的新网站。.
我应该使用哪个列表来提取足迹?
请使用您已验证的列表。GSA SER 已在这些网站上建立了链接,因此 XRumer 从中找到的模式指向它可以发布内容的网站。请先合并文件并删除重复的域名。.
进行链式模式分析时,我应该使用哪些 XRumer 设置?
将分析范围设置为 /filename,报告格式设置为 Google 网址,并勾选“仅限制报告结果数为 1000 条”。然后将 TXT 选项卡中的结果复制到文本文件中。.
Google 搜索运算符(例如 inurl:)现在还能用吗?
是的。inurl:、intitle: 和 site: 在 2026 年仍然适用于 Google。较旧的运算符,例如 cache:、link: 和 info: 已不再有效,并且一些其他搜索引擎无法识别 inurl:。.
为什么 Scrapebox 现在在谷歌搜索结果中排名下降了?
自 2025 年 1 月起,谷歌要求用户必须启用 JavaScript 才能使用搜索功能;同年 9 月,谷歌取消了每页显示 100 条搜索结果的选项。网络爬虫需要更多的代理服务器和请求,因此必应和其他搜索引擎通常是获取更多搜索结果的更佳选择。.
我需要使用 XRumer 来查找 GSA SER 封装吗?
不。GSA SER 为其支持的每个引擎都有自己的特征码。XRumer 的优势在于,它能在您已验证的网站中查找额外的 URL 模式,这通常会发现默认特征码遗漏的目标。.
目标越多,已验证的链接就越多。获取我们已验证的链接列表以提取足迹,或者让我们为您抓取新的目标。.

 English
 简体中文
 Deutsch (Sie)
 Bahasa Indonesia
 Italiano
 日本語
 한국어
 Português do Brasil
 Русский
 Español de México
 ไทย
 Tiếng Việt
 Türkçe