
Muitos GSA Search Engine Ranker Os usuários também possuem uma cópia de XRumer. Some bought it years ago, and many got it for the Solucionador de captcha XEvil that comes with it. Most of them never touch XRumer’s other tools, which is a pity, because one of them is very good at finding new targets for GSA SER.
Essa ferramenta é Análise de padrões de links. Ele lê uma lista de URLs para as quais você já publicou e extrai os padrões de URL que elas compartilham. Esses padrões se tornam rastros que você pode usar para coletar dados, permitindo encontrar mais sites que utilizam as mesmas plataformas. Escrevi este guia pela primeira vez em 2019 e o atualizei em outubro de 2026, incluindo as mudanças ocorridas na coleta de dados do Google desde então.
Resposta rápida: encontre as pegadas GSA SER com o XRumer.
- Utilize seu GSA SER verificado Liste como fonte, pois a GSA SER já publicou nesses sites.
- No GSA SER, combine os arquivos verificados em um único arquivo e remova os domínios duplicados.
- No XRumer, abra Ferramentas > Análise de padrões de links, carregue o arquivo e defina o Escopo de Análise para /nome do arquivo e formato de relatório para Google “inurl”.
- Para limitar o relatório a 1.000 resultados, clique em Iniciar e copie a guia Texto para um arquivo de pegadas.
- No Scrapebox, combine os registros com suas palavras-chave de nicho e colete dados, principalmente do Bing e do Google.
- Importe os URLs extraídos para o GSA SER e deixe que ele identifique as plataformas.
O que são pegadas no GSA SER?
Uma pegada digital é um trecho de texto ou um padrão de URL que todos os sites em uma determinada plataforma compartilham. Um site WordPress, por exemplo, geralmente exibe "Powered by WordPress" no rodapé, a menos que o proprietário o tenha removido, e suas páginas usam caminhos como: /wp-login.php. Todo sistema de gerenciamento de conteúdo deixa rastros como esses em seus URLs, títulos de página ou conteúdo.
Ao coletar dados de destino, você combina informações de domínio com palavras-chave e as envia para um mecanismo de busca. O mecanismo de busca retorna sites correspondentes, e esses são os sites nos quais o GSA SER pode publicar. O GSA SER já possui informações de domínio para todos os mecanismos de busca que suporta, mas uma lista criada a partir de seus próprios sites verificados geralmente encontra plataformas e padrões de URL que as informações de domínio padrão não identificam.
De quais operadores de pesquisa você precisa?
| Operador | O que encontra | Exemplo |
|---|---|---|
inurl: | Páginas com uma palavra ou caminho no URL | inurl:apple |
intitle: | Páginas com uma palavra no título da página | intitle:maçã |
site: | Páginas de um domínio ou TLD | site:apple.com |
Os três ainda trabalham no Google em 2026, de acordo com a lista da Ahrefs. Operadores de pesquisa do Google (atualizado em agosto de 2026). Alguns operadores mais antigos, como cache:, link: e informação:, não funcionam mais. Nem todos os mecanismos de busca entendem inurl:, o que é importante mais tarde, quando você for extrair os dados.
Como você prepara sua lista GSA SER para extração de dados de acesso?
Comece com o seu lista de sites verificados. Esses são sites nos quais a GSA SER já criou links, portanto, os rastros obtidos a partir deles apontam para sites nos quais ela pode publicar conteúdo.
- Uma única plataforma: Use um único arquivo da pasta verificada. Para sites de artigos do WordPress, isso é...
sitelist_Artigo-Artigo do WordPress. Para sites MediaWiki, ésitelist_Wiki-MediaWiki. - Todas as plataformas: Combine todos os arquivos verificados em um único arquivo e, em seguida, remova os domínios duplicados.
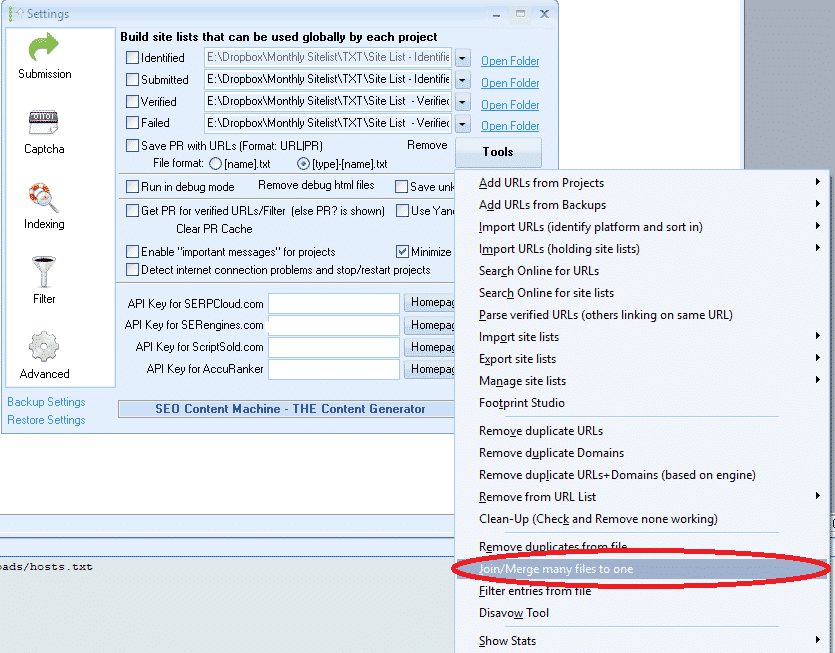
O GSA SER possui ferramentas para ambas as etapas. Acesse Opções > Avançado > Ferramentas e usar Unir/mesclar vários arquivos em um só., então Remover domínios duplicados do arquivo. O vídeo acima mostra ambos.
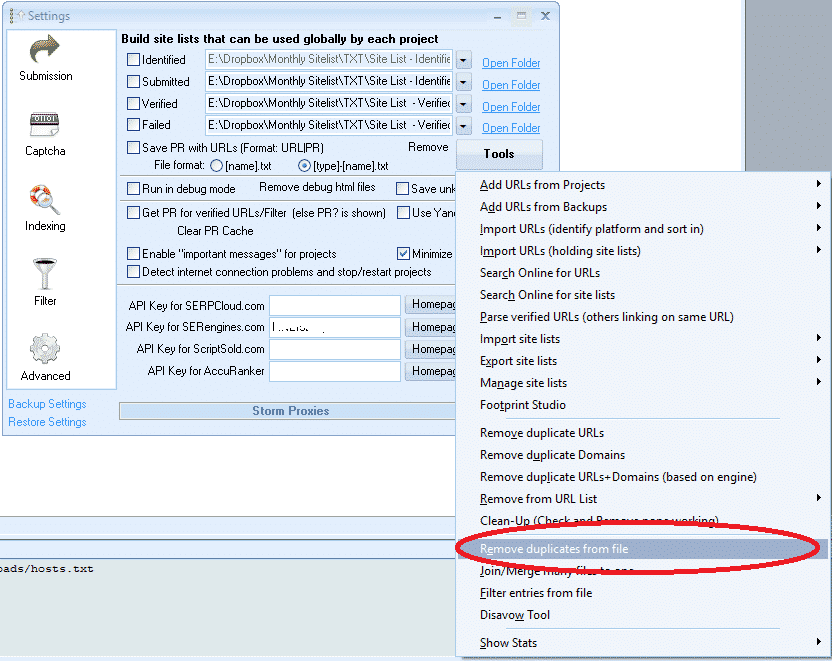
Se você ainda não possui uma lista verificada, a nossa Lista de links verificados pelo GSA SER currently holds 92,619,573 identified URLs and is updated once a day, which gives you a large source to extract footprints from.
Como extrair pegadas com a Análise de Padrões de Links do XRumer?
- No menu XRumer, abra Ferramentas.
- Escolher Análise de padrões de links.
- Na parte superior da tela, navegue até a lista que você preparou no GSA SER.
- Definir Escopo da análise para /nome do arquivo. Isso fornece a maior quantidade de resultados. Experimente também os outros escopos depois, pois eles encontram padrões diferentes.
- Definir Formato do relatório para Google “inurl”.
- Das quatro caixas de seleção abaixo, marque apenas Restringir relatório para e deixe em 1.000 resultados.
- Clique Começar.
- Quando terminar, abra o TXT guia (ao lado de TABELA e GRÁFICO).
- Selecione e copie todos os resultados, cole-os em um arquivo de texto e salve-o.
- Analise o arquivo e exclua as informações que não deseja, como palavras-chave simples. Se não tiver certeza, deixe-as.

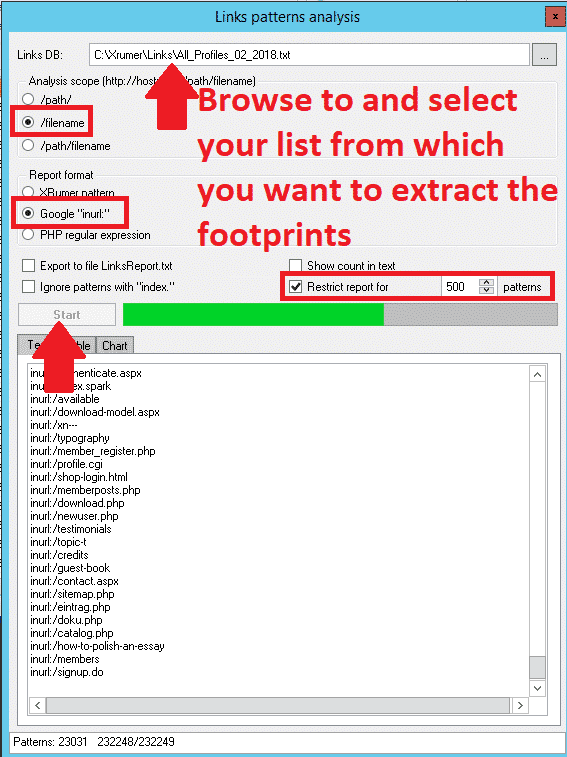
As capturas de tela são da versão do XRumer que eu usava em 2019. A versão atual é a XRumer 23, e eu não verifiquei novamente se os rótulos do menu mudaram de lugar, então procure a mesma ferramenta em Ferramentas caso sua tela esteja diferente.
Como faço para que os rastros funcionem em outros mecanismos de busca?
O Google entende inurl:, Mas alguns outros mecanismos de busca não. Se você só extrair dados do Google, deixe o arquivo como está. Se você também extrair dados de outros mecanismos, faça uma cópia do arquivo e remova o operador.
- Abra a cópia no Bloco de Notas e escolha Editar > Substituir.
- Em Descubra o que, digitar
inurl:. - Deixar Substitua por esvazie e clique Substituir tudo.
Use essa cópia para os mecanismos de busca que não sejam do Google, ou cole-a de volta no arquivo original se quiser executar uma única coleta de dados com ambas as versões.
Como faço para extrair dados usando as novas pegadas no Scrapebox?
O Scrapebox continua sendo o coletor mais fácil para isso. A versão atual é a 2.1.57 (janeiro de 2026), vendida como uma compra única.
- Na janela principal do Scrapebox, selecione Pegada personalizada.
- Insira suas palavras-chave ou importe-as de um arquivo. Use palavras-chave relacionadas ao seu nicho. Quanto mais palavras-chave você adicionar, mais tempo levará a extração. serviço de extração de palavras-chave Podemos criar uma extensa lista de palavras-chave de nicho para você.
- Clique no M Botão para mesclar seu arquivo de pegadas com as palavras-chave.
- Clique Comece a colheita.
- Escolha os mecanismos de busca. Eu começo com o Bing e o Google, porque eles retornam mais resultados.
- Na colheitadeira Proxies guia, marcar Ativar carregamento automático (a partir de arquivo) e selecione seu arquivo de proxies.
- Clique Começar.
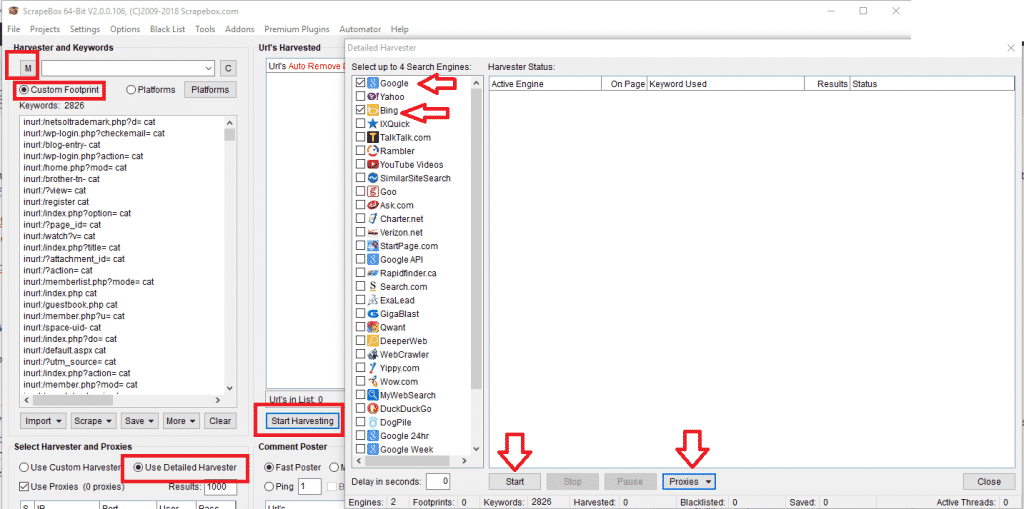
Para obter mais detalhes sobre a colheitadeira, consulte o Perguntas frequentes sobre a colhedora Scrapebox.
Por que extrair dados do Google será mais difícil em 2026?
Duas alterações ocorridas desde a publicação original deste guia tornaram a extração de dados do Google mais lenta:
- Requisito de JavaScript: Desde janeiro de 2025, o Google solicita que os visitantes habilitem o JavaScript para usar a Busca. Um porta-voz do Google disse ao TechCrunch que isso visa proteger melhor a Busca contra bots e spam. Agora, ferramentas simples de extração de dados que não executam JavaScript falham com mais frequência.
- Não haverá mais de 100 resultados por página: Em setembro de 2025, o Google deixou de oferecer suporte ao
&num=100parâmetro, portanto, um scraper precisa de dez requisições para obter 100 resultados em vez de uma.
Na prática, isso significa mais proxies, mais consultas com falha e coletas mais lentas do Google. O Bing e os outros mecanismos de busca compatíveis com o Scrapebox costumam ser fontes de volume melhores atualmente. Bons proxies privados são mais importantes do que nunca: veja nosso serviço proxy.
O que você faz com os URLs extraídos?
Remova os domínios duplicados no Scrapebox e, em seguida, importe a lista para o GSA SER. Você pode importá-la diretamente para um projeto como URLs de destino ou usar Opções > Avançado > Ferramentas > Importar URLs (identificar plataforma e classificar) Assim, o GSA SER os classifica em sua lista de identificados por plataforma. Execute-os em um projeto e aqueles que funcionarem serão adicionados à sua lista verificada, que você poderá então usar novamente no XRumer para a próxima rodada.
Se preferir não se arranhar, nosso serviço de extração de URLs de destino Faz isso por você.
Perguntas frequentes
O que é uma pegada no GSA Search Engine Ranker?
Uma pegada digital é um padrão de texto ou URL compartilhado por todos os sites em uma plataforma, como um caminho na URL ou uma linha no rodapé. Combinada com palavras-chave em um mecanismo de busca, a pegada digital encontra novos sites nos quais o GSA SER pode publicar conteúdo.
Qual lista devo usar para extrair as pegadas?
Use sua lista verificada. O GSA SER já criou links nesses sites, então os padrões que o XRumer encontra neles apontam para sites nos quais ele pode publicar. Primeiro, mescle os arquivos e remova os domínios duplicados.
Quais configurações do XRumer devo usar para a Análise de Padrões de Links?
Defina o Escopo da Análise como /nome_do_arquivo, o Formato do Relatório como URL do Google e marque apenas a opção Restringir relatório a 1.000 resultados. Em seguida, copie os resultados da guia TXT para um arquivo de texto.
Os operadores de pesquisa do Google, como inurl:, ainda funcionam?
Sim. Os operadores inurl:, intitle: e site: ainda funcionam no Google em 2026. Operadores mais antigos, como cache:, link: e info:, não funcionam mais, e alguns outros mecanismos de busca não entendem inurl:.
Por que o Scrapebox está recebendo menos resultados do Google agora?
Desde janeiro de 2025, o Google exige JavaScript para usar a Busca e, em setembro de 2025, removeu a opção de exibir 100 resultados por página. Os scrapers precisam de mais proxies e mais requisições, então o Bing e outros mecanismos de busca costumam ser uma fonte melhor de volume.
Preciso do XRumer para encontrar as pegadas GSA SER?
Não. O GSA SER possui seus próprios padrões de URL para cada mecanismo que suporta. O XRumer é útil porque encontra padrões de URL adicionais em seus sites verificados, o que frequentemente revela alvos que os padrões de URL padrão não detectam.
Mais alvos significam mais links verificados. Obtenha nossa lista de links verificados para extrair informações ou deixe-nos coletar novos alvos para você.
 English
 简体中文
 Deutsch (Sie)
 Bahasa Indonesia
 Italiano
 日本語
 한국어
 Português do Brasil
 Русский
 Español de México
 ไทย
 Tiếng Việt
 Türkçe