
Nhiều Công cụ xếp hạng công cụ tìm kiếm GSA người dùng cũng sở hữu một bản sao của XRumer. Một số người đã mua nó từ nhiều năm trước, và nhiều người khác mua vì phần mềm giải mã captcha XEvil đi kèm. Hầu hết họ không bao giờ sử dụng các công cụ khác của XRumer, điều này thật đáng tiếc, bởi vì một trong số chúng rất tốt trong việc tìm kiếm các mục tiêu mới cho GSA SER.
Công cụ đó là Phân tích mẫu liên kết. Nó đọc danh sách các URL mà bạn đã đăng bài lên và trích xuất các mẫu URL mà chúng chia sẻ. Những mẫu đó trở thành dấu vết mà bạn có thể sử dụng để thu thập dữ liệu, giúp bạn tìm thấy nhiều trang web khác sử dụng cùng nền tảng. Tôi viết hướng dẫn này lần đầu vào năm 2019 và cập nhật vào tháng 10 năm 2026, bao gồm cả những thay đổi trong việc thu thập dữ liệu từ Google kể từ đó.
Câu trả lời nhanh: tìm dấu vết GSA SER bằng XRumer.
- Sử dụng GSA SER của bạn đã được xác minh Hãy liệt kê danh sách đó làm nguồn, vì GSA SER đã đăng tải thông tin lên các trang web đó rồi.
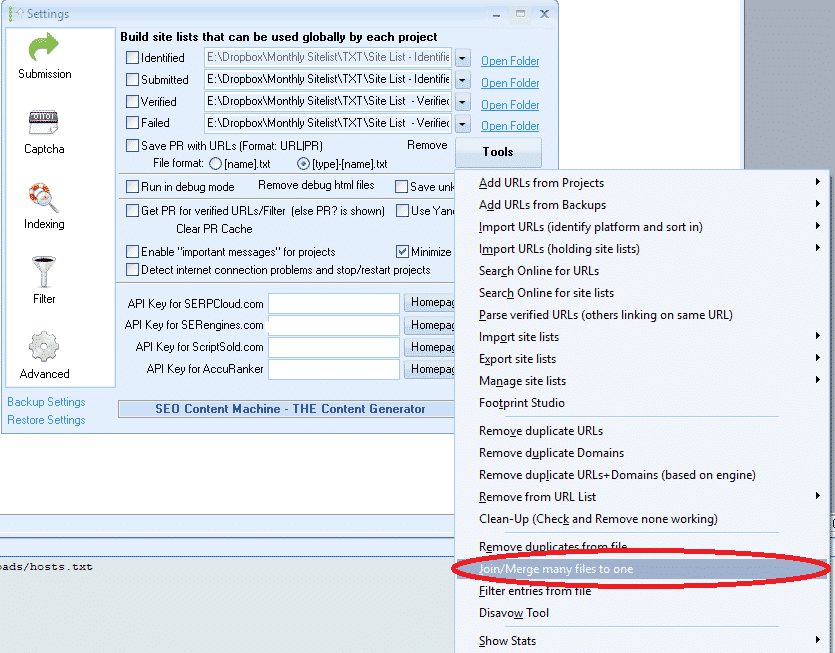
- Trong GSA SER, hãy hợp nhất các tệp đã được xác minh thành một tệp duy nhất và loại bỏ các tên miền trùng lặp.
- Trong XRumer, hãy mở Công cụ > Phân tích mẫu liên kết, tải tệp, đặt Phạm vi phân tích thành /tên tệp và Định dạng Báo cáo cho Google “inurl”.
- Giới hạn báo cáo ở 1.000 kết quả, nhấp vào Bắt đầu, sau đó sao chép tab Văn bản vào tệp dấu chân.
- Trong Scrapebox, hãy kết hợp dấu vết tìm kiếm với từ khóa chuyên ngành của bạn và thu thập dữ liệu, chủ yếu từ Bing và Google.
- Nhập các URL đã thu thập được vào GSA SER và để nó xác định các nền tảng.
Dấu chân (Footprint) trong GSA SER là gì?
Dấu chân URL là một đoạn văn bản hoặc mẫu URL mà mọi trang web trên một nền tảng nhất định đều có chung. Ví dụ, một trang web WordPress thường hiển thị "Được cung cấp bởi WordPress" ở chân trang trừ khi chủ sở hữu đã xóa nó, và các trang của nó sử dụng các đường dẫn như sau: /wp-login.php. Mỗi hệ thống quản lý nội dung đều để lại những dấu vết như thế này trong URL, tiêu đề trang hoặc nội dung của nó.
Khi bạn thu thập thông tin về các mục tiêu, bạn kết hợp dấu vết tìm kiếm với từ khóa và gửi chúng đến công cụ tìm kiếm. Công cụ tìm kiếm sẽ trả về các trang web phù hợp, và đó là những trang web mà GSA SER có thể đăng bài lên. GSA SER đã có dấu vết tìm kiếm cho mọi công cụ mà nó hỗ trợ, nhưng danh sách được tạo từ các trang web đã được xác minh của riêng bạn thường tìm thấy các nền tảng và mẫu URL mà dấu vết tìm kiếm mặc định bỏ sót.
Bạn cần những toán tử tìm kiếm nào?
| Người vận hành | Những gì nó tìm thấy | Ví dụ |
|---|---|---|
inurl: | Các trang có chứa từ hoặc đường dẫn trong URL. | inurl:apple |
tiêu đề: | Các trang có chứa một từ trong tiêu đề trang | intitle:apple |
địa điểm: | Các trang từ một tên miền hoặc TLD duy nhất | Trang web: apple.com |
Theo danh sách của Ahrefs, cả ba người này vẫn sẽ làm việc tại Google vào năm 2026. Các toán tử tìm kiếm của Google (cập nhật tháng 8 năm 2026). Một số nhà mạng cũ hơn, chẳng hạn như bộ nhớ đệm:, liên kết: và thông tin:, Không còn hoạt động nữa. Không phải công cụ tìm kiếm nào cũng hiểu điều đó. inurl:, Điều này sẽ quan trọng sau này khi bạn thực hiện việc thu thập dữ liệu.
Bạn chuẩn bị danh sách GSA SER của mình như thế nào để trích xuất dấu vết?
Hãy bắt đầu với bạn danh sách trang web đã được xác minh. Đây là những trang web mà GSA SER đã xây dựng liên kết, vì vậy dấu vết được lấy từ chúng trỏ đến các trang web mà nó có thể đăng bài lên.
- Chỉ một nền tảng duy nhất: Sử dụng một tệp duy nhất từ thư mục đã được xác minh. Đối với các trang web bài viết WordPress thì đó là...
sitelist_Article-WordPress Article. Đối với các trang web MediaWiki thì đó là...sitelist_Wiki-MediaWiki. - Tất cả các nền tảng: Hợp nhất tất cả các tệp đã được xác minh thành một tệp duy nhất, sau đó loại bỏ các tên miền trùng lặp.
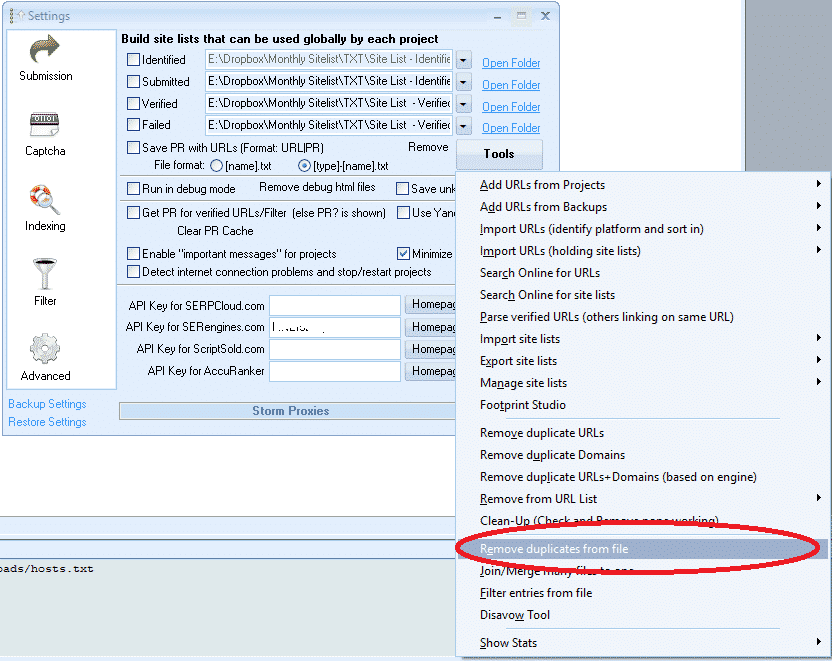
GSA SER có các công cụ cho cả hai bước. Truy cập vào... Tùy chọn > Nâng cao > Công cụ và sử dụng Ghép/Ghép nhiều tập tin thành một tập tin, sau đó Xóa các tên miền trùng lặp khỏi tệp. Video trên minh họa cả hai trường hợp.
Nếu bạn chưa có danh sách đã được xác minh của riêng mình, hãy sử dụng danh sách của chúng tôi. Danh sách liên kết đã được xác minh của GSA SER Hiện tại, kho dữ liệu này chứa 92.393.047 URL đã được xác định và được cập nhật mỗi ngày một lần, cung cấp cho bạn một nguồn dữ liệu lớn để trích xuất dấu vết.
Làm thế nào để trích xuất dấu vết bằng XRumer Links Pattern Analysis?
- Trong menu XRumer, hãy mở Công cụ.
- Chọn Phân tích mẫu liên kết.
- Ở đầu màn hình, hãy tìm đến danh sách bạn đã chuẩn bị trong GSA SER.
- Bộ Phạm vi phân tích ĐẾN /tên tệp. Cách này cho kết quả tốt nhất. Sau đó, hãy thử các chế độ xem khác nữa, vì chúng tìm ra các mẫu khác nhau.
- Bộ Định dạng báo cáo ĐẾN Google “inurl”.
- Trong bốn ô kiểm bên dưới, chỉ đánh dấu vào một trong bốn ô. Hạn chế báo cáo cho và giữ nguyên ở mức 1.000 kết quả.
- Nhấp chuột Bắt đầu.
- Khi quá trình hoàn tất, hãy mở ra TXT tab (bên cạnh TABLE và CHART).
- Chọn và sao chép tất cả các kết quả, dán chúng vào một tệp văn bản và lưu lại.
- Hãy xem lại toàn bộ tập tin và xóa những dấu vết bạn không muốn, chẳng hạn như các từ khóa thông thường. Nếu bạn không chắc chắn, hãy để chúng lại.

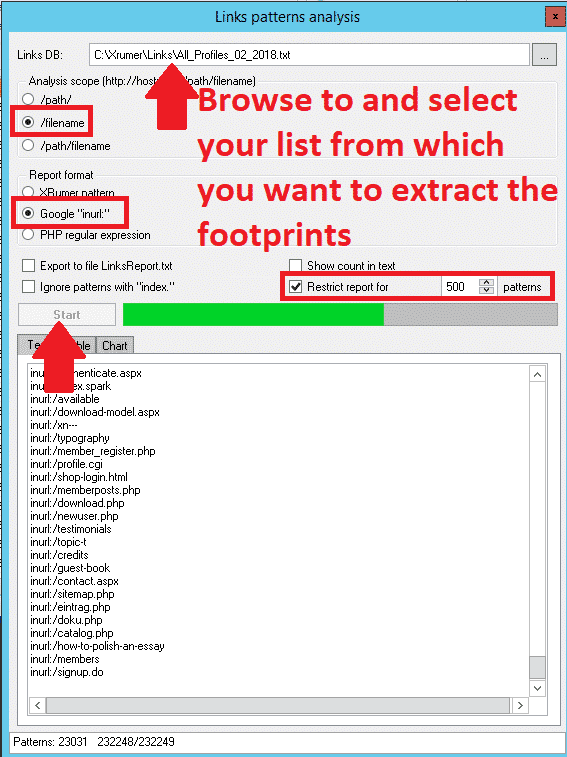
Ảnh chụp màn hình là từ phiên bản XRumer mà tôi đã sử dụng vào năm 2019. Phiên bản hiện tại là XRumer 23, và tôi chưa kiểm tra lại xem các nhãn menu có bị thay đổi vị trí hay không, vì vậy nếu màn hình của bạn trông khác, hãy tìm công cụ tương tự trong mục Công cụ.
Làm thế nào để dấu vết tìm kiếm hoạt động trên các công cụ tìm kiếm khác?
Google hiểu điều đó. inurl:, Nhưng một số công cụ tìm kiếm khác thì không. Nếu bạn chỉ thu thập dữ liệu từ Google, hãy giữ nguyên tệp tin. Nếu bạn cũng thu thập dữ liệu từ các công cụ tìm kiếm khác, hãy sao chép tệp tin và loại bỏ toán tử đó:
- Mở bản sao trong Notepad và chọn Chỉnh sửa > Thay thế.
- Trong Tìm kiếm những gì, đi vào
inurl:. - Rời khỏi Thay thế bằng trống và nhấp chuột Thay thế tất cả.
Hãy sử dụng bản sao đó cho các công cụ tìm kiếm không phải của Google, hoặc dán lại vào tệp gốc nếu bạn muốn chạy một lần quét với cả hai phiên bản.
Bạn thu thập dữ liệu bằng cách nào với các dấu vết mới trong Scrapebox?
Scrapebox vẫn là công cụ thu thập dữ liệu dễ sử dụng nhất cho việc này. Phiên bản hiện tại là 2.1.57 (tháng 1 năm 2026), được bán dưới dạng mua một lần.
- Trong cửa sổ chính của Scrapebox, hãy chọn Dấu chân tùy chỉnh.
- Nhập từ khóa của bạn hoặc nhập chúng từ một tệp. Sử dụng các từ khóa liên quan đến lĩnh vực kinh doanh của bạn. Càng thêm nhiều từ khóa, quá trình thu thập dữ liệu càng mất nhiều thời gian. dịch vụ thu thập từ khóa có thể xây dựng một danh sách từ khóa chuyên biệt lớn cho bạn.
- Nhấp chuột vào M Nút này dùng để hợp nhất tập tin dấu chân của bạn với các từ khóa.
- Nhấp chuột Bắt đầu thu hoạch.
- Hãy chọn công cụ tìm kiếm. Tôi bắt đầu với Bing và Google, vì chúng trả về nhiều kết quả nhất.
- Trên máy gặt Proxy tab, dấu tích Bật chế độ tự động tải (từ tệp) và chọn tệp proxy của bạn.
- Nhấp chuột Bắt đầu.
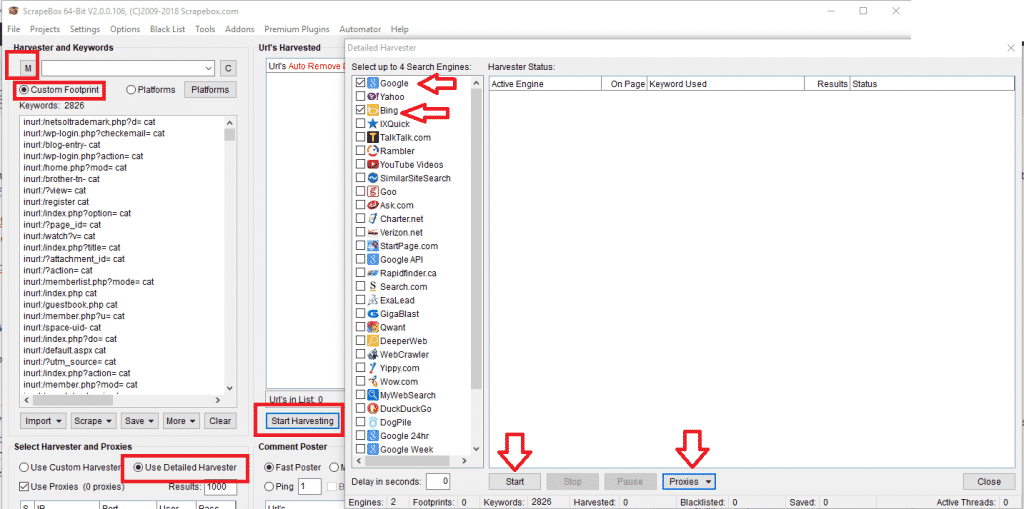
Để biết thêm chi tiết về máy gặt, hãy xem phần [liên kết đến trang web của nhà sản xuất]. Câu hỏi thường gặp về công cụ thu thập dữ liệu Scrapebox.
Tại sao việc thu thập dữ liệu từ Google lại khó khăn hơn vào năm 2026?
Hai thay đổi kể từ khi hướng dẫn này được viết lần đầu đã khiến quá trình thu thập dữ liệu của Google chậm hơn:
- Yêu cầu JavaScript: Kể từ tháng 1 năm 2025, Google yêu cầu người dùng bật JavaScript để sử dụng chức năng Tìm kiếm. Một phát ngôn viên của Google nói với TechCrunch rằng điều này nhằm mục đích bảo vệ tốt hơn chức năng Tìm kiếm khỏi các bot và thư rác. Các trình thu thập dữ liệu đơn giản không chạy JavaScript giờ đây thường xuyên gặp lỗi hơn.
- Không còn 100 kết quả mỗi trang nữa: Vào tháng 9 năm 2025, Google đã ngừng hỗ trợ.
&num=100tham số, vì vậy trình thu thập dữ liệu cần mười yêu cầu để nhận được 100 kết quả thay vì chỉ một.
Trên thực tế, điều đó có nghĩa là nhiều máy chủ proxy hơn, nhiều truy vấn thất bại hơn và quá trình thu thập dữ liệu từ Google chậm hơn. Bing và các công cụ tìm kiếm khác mà Scrapebox hỗ trợ thường là nguồn dữ liệu tốt hơn hiện nay. Các máy chủ proxy riêng tốt quan trọng hơn bao giờ hết: xem phần của chúng tôi dịch vụ proxy.
Bạn làm gì với các URL đã thu thập được?
Xóa các tên miền trùng lặp trong Scrapebox, sau đó nhập danh sách vào GSA SER. Bạn có thể nhập trực tiếp vào dự án dưới dạng URL đích hoặc sử dụng Tùy chọn > Nâng cao > Công cụ > Nhập URL (xác định nền tảng và sắp xếp theo) Vì vậy, GSA SER sẽ sắp xếp chúng vào danh sách đã được xác định của bạn theo nền tảng. Chạy chúng qua một dự án và những dự án hoạt động tốt sẽ được đưa vào danh sách đã được xác minh của bạn, sau đó bạn có thể đưa danh sách này trở lại XRumer cho vòng tiếp theo.
Nếu bạn không muốn tự làm trầy xước da, hãy sử dụng sản phẩm của chúng tôi. dịch vụ trích xuất URL mục tiêu Nó làm điều đó thay cho bạn.
Câu hỏi thường gặp
Dấu chân (footprint) trong GSA Search Engine Ranker là gì?
Dấu vết (footprint) là một đoạn văn bản hoặc mẫu URL được chia sẻ bởi mọi trang web trên một nền tảng, chẳng hạn như đường dẫn trong URL hoặc một dòng trong chân trang. Kết hợp với từ khóa trong công cụ tìm kiếm, dấu vết giúp tìm ra các trang web mới mà GSA SER có thể đăng bài lên.
Tôi nên sử dụng danh sách nào để trích xuất dấu chân?
Hãy sử dụng danh sách đã được xác minh của bạn. GSA SER đã xây dựng các liên kết trên các trang web đó, vì vậy các mẫu mà XRumer tìm thấy trong đó sẽ trỏ đến các trang web mà nó có thể đăng bài lên. Trước tiên, hãy hợp nhất các tệp và loại bỏ các tên miền trùng lặp.
Tôi nên sử dụng cài đặt XRumer nào cho Phân tích mẫu liên kết?
Đặt Phạm vi phân tích thành /filename, Định dạng báo cáo thành Google inurl, và chỉ chọn Giới hạn báo cáo cho 1.000 kết quả. Sau đó sao chép kết quả từ tab TXT vào một tệp văn bản.
Các toán tử tìm kiếm của Google như inurl: vẫn còn hoạt động không?
Đúng vậy. inurl:, intitle: và site: vẫn hoạt động trên Google vào năm 2026. Các toán tử cũ hơn như cache:, link: và info: không còn hoạt động nữa, và một số công cụ tìm kiếm khác không hiểu inurl:.
Tại sao Scrapebox lại có ít kết quả tìm kiếm trên Google hơn hiện nay?
Từ tháng 1 năm 2025, Google yêu cầu sử dụng JavaScript để tìm kiếm, và vào tháng 9 năm 2025, họ đã loại bỏ tùy chọn hiển thị 100 kết quả mỗi trang. Các công cụ thu thập dữ liệu cần nhiều máy chủ proxy và nhiều yêu cầu hơn, vì vậy Bing và các công cụ tìm kiếm khác thường là nguồn cung cấp dữ liệu tốt hơn.
Tôi có cần XRumer để tìm dấu vết GSA SER không?
Không. GSA SER có dấu vết riêng cho mỗi công cụ mà nó hỗ trợ. XRumer hữu ích vì nó tìm thấy các mẫu URL bổ sung trong các trang web đã được xác minh của bạn, điều này thường giúp phát hiện ra các mục tiêu mà dấu vết mặc định bỏ sót.
Càng nhiều mục tiêu, càng nhiều liên kết được xác thực. Hãy sử dụng danh sách liên kết đã được xác thực của chúng tôi để trích xuất dấu vết, hoặc để chúng tôi tìm kiếm các mục tiêu mới cho bạn.
 English
 简体中文
 Deutsch (Sie)
 Bahasa Indonesia
 Italiano
 日本語
 한국어
 Português do Brasil
 Русский
 Español de México
 ไทย
 Tiếng Việt
 Türkçe