
Много GSA Search Engine Ranker пользователи также владеют копией XRumer. Некоторые купили его много лет назад, а многие — из-за входящего в комплект решателя капчи XEvil. Большинство из них никогда не пользовались другими инструментами XRumer, что очень жаль, потому что один из них отлично подходит для поиска новых целей для GSA SER.
Этот инструмент Анализ структуры связей. Он считывает список URL-адресов, на которые вы уже отправляете данные, и извлекает общие шаблоны URL-адресов. Эти шаблоны становятся «следами», которые можно использовать для парсинга, позволяя находить больше сайтов, работающих на тех же платформах. Я впервые написал это руководство в 2019 году и обновил его в октябре 2026 года, включив в него изменения, произошедшие с тех пор в парсинге Google.
Быстрый ответ: найдите следы GSA SER с помощью XRumer.
- Используйте свой GSA SER проверено Укажите источник, поскольку GSA SER уже разместила информацию на этих сайтах.
- В GSA SER объедините проверенные файлы в один файл и удалите повторяющиеся домены.
- В XRumer откройте Инструменты > Анализ структуры связей, Загрузите файл, установите область анализа на /имя файла и формат отчета для Google “inurl”.
- Ограничьте количество результатов в отчете до 1000, нажмите «Начать», затем скопируйте вкладку «Текст» в файл с данными о местоположении.
- В Scrapebox объедините полученные данные с ключевыми словами вашей ниши и собирайте их, в основном, из Bing и Google.
- Импортируйте собранные URL-адреса в GSA SER и позвольте системе определить платформы.
Что такое «следы» в GSA SER?
Футпринт — это фрагмент текста или шаблон URL-адреса, общий для всех сайтов на определенной платформе. Например, на сайте WordPress обычно в футере отображается надпись “Powered by WordPress”, если владелец ее не удалил, а на его страницах используются пути, например, такие: /wp-login.php. Каждая система управления контентом оставляет подобные следы в своих URL-адресах, заголовках страниц или содержимом.
При сборе данных о целевых сайтах вы объединяете поисковые запросы с ключевыми словами и отправляете их в поисковую систему. Поисковая система возвращает сайты, соответствующие запросу, и именно на эти сайты GSA SER может размещать свои данные. GSA SER уже имеет поисковые запросы для каждой поддерживаемой поисковой системы, но список, составленный на основе ваших собственных проверенных сайтов, часто обнаруживает платформы и шаблоны URL-адресов, которые отсутствуют в стандартных поисковых запросах.
Какие операторы поиска вам нужны?
| Оператор | Что оно обнаруживает | Пример |
|---|---|---|
inurl: | Страницы, содержащие слово или путь в URL-адресе. | inurl:apple |
заголовок: | Страницы, содержащие слово в заголовке страницы | intitle:apple |
сайт: | Страницы с одного домена или верхнего уровня (TLD). | сайт:apple.com |
Согласно списку Ahrefs, все трое по-прежнему будут работать в Google в 2026 году. операторы поиска Google (обновлено в августе 2026 г.). Некоторые более старые операторы, такие как кэш:, связь: и информация:, Больше не работает. Не все поисковые системы это понимают. inurl:, что имеет значение позже, когда вы будете производить парсинг.
Как подготовить список GSA SER для извлечения информации о местонахождении данных?
Начните с вашего проверенный список сайтов. Это сайты, на которые GSA SER уже создала ссылки, поэтому полученные с них данные указывают на сайты, на которые она может размещать сообщения.
- Только одна платформа: Используйте один файл из проверенной папки. Для сайтов со статьями на WordPress это необходимо.
sitelist_Article-WordPress Article. Для сайтов MediaWiki этоsitelist_Wiki-MediaWiki. - Все платформы: Объедините все проверенные файлы в один файл, затем удалите повторяющиеся домены.
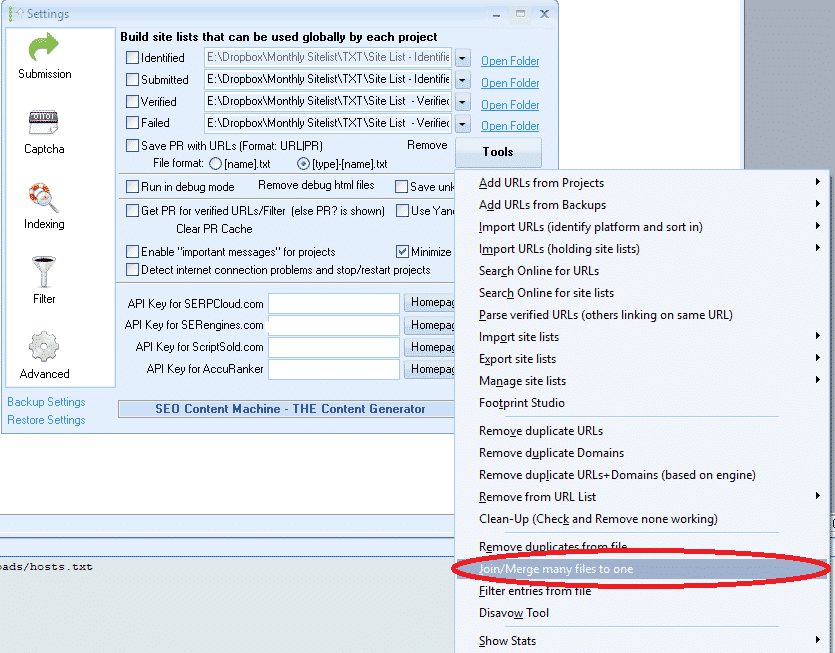
В GSA SER есть инструменты для обоих этапов. Перейдите по ссылке: Параметры > Дополнительно > Инструменты и использовать Объединение/слияние нескольких файлов в один., затем Удалите повторяющиеся домены из файла.. На видео выше показаны оба варианта.
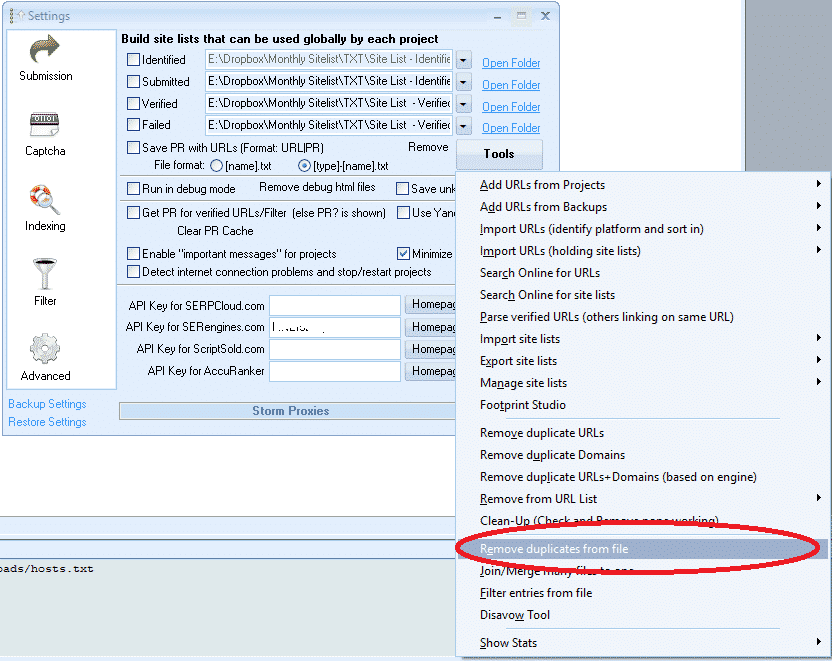
Если у вас еще нет собственного проверенного списка, наш Список проверенных ссылок GSA SER В настоящее время содержит 92 393 047 идентифицированных URL-адресов и обновляется раз в день, что предоставляет большой источник для извлечения следов.
Как извлечь следы ссылок с помощью анализа шаблонов ссылок XRumer?
- В меню XRumer откройте Инструменты.
- Выбирать Анализ структуры связей.
- В верхней части экрана перейдите к списку, который вы подготовили в GSA SER.
- Набор Область анализа в /имя файла. Это даёт наилучшие результаты. После этого попробуйте использовать и другие осциллографы, так как они выявляют другие закономерности.
- Набор Формат отчета в Google “inurl”.
- Из четырех приведенных ниже флажков отметьте только один. Ограничить отчет для и оставьте количество результатов на уровне 1000.
- Нажмите Начинать.
- Когда процесс завершится, откройте ТЕКСТ вкладка (рядом с TABLE и CHART).
- Выделите и скопируйте все результаты, вставьте их в текстовый файл и сохраните его.
- Просмотрите файл и удалите ненужные следы, например, просто ключевые слова. Если вы не уверены, оставьте их.

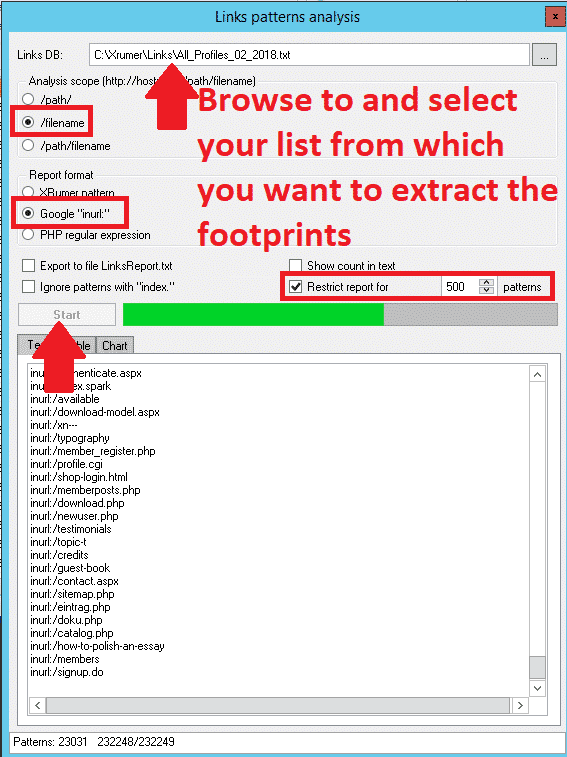
Скриншоты сделаны с той версии XRumer, которую я использовал в 2019 году. Текущая версия — XRumer 23, и я не проверял, переместились ли названия пунктов меню, поэтому, если ваш экран выглядит иначе, поищите тот же инструмент в разделе «Инструменты».
Как добиться того, чтобы эти следы отображались в других поисковых системах?
Google понимает inurl:, но некоторые другие поисковые системы этого не делают. Если вы парсите только Google, оставьте файл как есть. Если вы также парсите другие поисковые системы, сделайте копию файла и удалите оператор:
- Откройте копию в Блокноте и выберите Редактировать > Заменить.
- В Найдите то, что, входить
inurl:. - Оставлять Заменить на пусто и нажмите Заменить все.
Используйте этот текст для поисковых систем, отличных от Google, или вставьте его обратно в исходный файл, если хотите выполнить один поиск с обеими версиями.
Как работать с новыми функциями Scrapebox?
Scrapebox по-прежнему остается самым простым в использовании инструментом для сбора ресурсов. Текущая версия — 2.1.57 (январь 2026 г.), продается как разовая покупка.
- В главном окне Scrapebox выберите Индивидуальная планировка.
- Введите ключевые слова или импортируйте их из файла. Используйте ключевые слова, связанные с вашей нишей. Чем больше вы добавите, тем дольше займет сбор данных. сервис сбора ключевых слов может составить для вас большой список ключевых слов по нише.
- Нажмите M кнопка для объединения файла с отпечатками пальцев с ключевыми словами.
- Нажмите Начать сбор урожая.
- Выберите поисковые системы. Я начинаю с Bing и Google, потому что они выдают наибольшее количество результатов.
- На комбайне Прокси таб, галочка Включить автоматическую загрузку (из файла) и выберите файл с прокси-серверами.
- Нажмите Начинать.
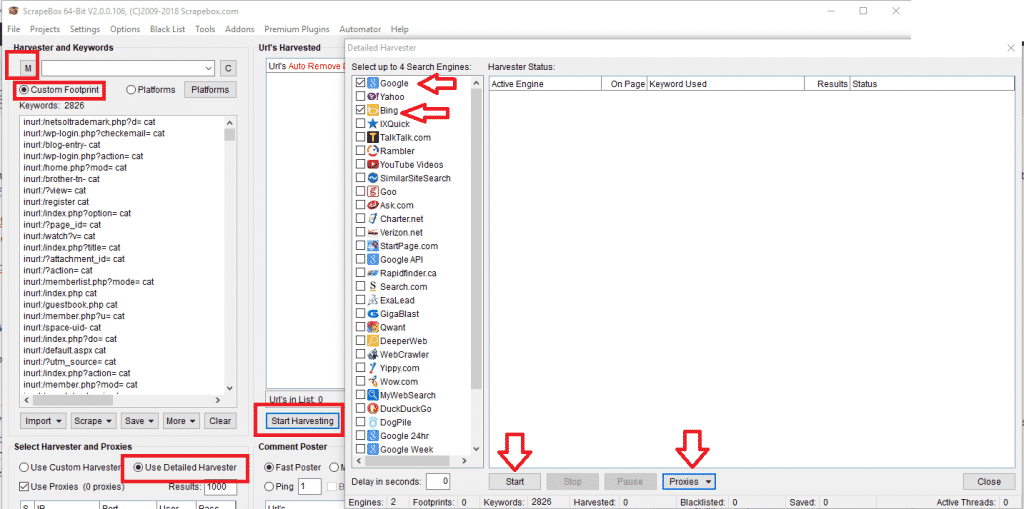
Для получения более подробной информации о комбайне см. Часто задаваемые вопросы о комбайне Scrapebox.
Почему в 2026 году парсинг данных из Google стал сложнее?
Два изменения, произошедшие с момента написания этого руководства, замедляют работу Google по сбору данных:
- Требование к JavaScript: Начиная с января 2025 года Google просит посетителей включать JavaScript для использования поиска. Представитель Google сообщил TechCrunch, что это сделано для лучшей защиты поиска от ботов и спама. Простые парсеры, не использующие JavaScript, теперь чаще дают сбои.
- Не более 100 результатов на странице: В сентябре 2025 года Google прекратил поддержку...
&num=100из-за этого парсеру требуется десять запросов, чтобы получить 100 результатов вместо одного.
На практике это означает больше прокси, больше неудачных запросов и более медленный сбор данных от Google. Bing и другие поисковые системы, поддерживаемые Scrapebox, часто являются лучшим источником трафика. Хорошие частные прокси важны как никогда: см. наш прокси-сервис.
Что вы делаете с полученными URL-адресами?
Удалите дубликаты доменов в Scrapebox, затем импортируйте список в GSA SER. Вы можете импортировать его непосредственно в проект как целевые URL-адреса или использовать Параметры > Дополнительно > Инструменты > Импорт URL-адресов (определите платформу и выполните сортировку) Таким образом, GSA SER сортирует их по платформам в соответствии с вашим списком идентифицированных пользователей. Пропустите их через проект, и те, которые сработают, попадут в ваш список проверенных пользователей, который затем можно будет передать обратно в XRumer для следующего этапа проверки.
Если вы не хотите поцарапаться, наш сервис для сбора целевых URL-адресов Это сделает за вас.
Часто задаваемые вопросы
Что такое «след» в поисковой выдаче GSA Search Engine Ranker?
Футпринт — это текстовый или URL-шаблон, общий для каждого сайта на платформе, например, путь в URL-адресе или строка в нижнем колонтитуле. В сочетании с ключевыми словами в поисковой системе футпринты позволяют находить новые сайты, на которые GSA SER может размещать свои материалы.
Какой список следует использовать для извлечения следов?
Используйте свой проверенный список. GSA SER уже создала ссылки на этих сайтах, поэтому шаблоны, которые XRumer в них обнаруживает, указывают на сайты, на которые можно размещать сообщения. Сначала объедините файлы и удалите дублирующиеся домены.
Какие настройки XRumer следует использовать для анализа шаблонов ссылок?
Установите область анализа на /filename, формат отчета на Google inurl и отметьте только пункт «Ограничить отчет до 1000 результатов». Затем скопируйте результаты с вкладки TXT в текстовый файл.
Работают ли до сих пор поисковые операторы Google, такие как inurl:?
Да. Операторы inurl:, intitle: и site: по-прежнему работают в Google в 2026 году. Более старые операторы, такие как cache:, link: и info:, больше не работают, а некоторые другие поисковые системы не понимают inurl:.
Почему Scrapebox теперь получает меньше результатов в Google?
С января 2025 года Google требует использования JavaScript для работы поиска, а в сентябре 2025 года отказался от возможности отображения 100 результатов на странице. Для сбора данных требуется больше прокси и запросов, поэтому Bing и другие поисковые системы часто являются лучшим источником трафика.
Нужен ли мне XRumer для поиска следов GSA SER?
Нет. GSA SER имеет собственные шаблоны URL-адресов для каждого поддерживаемого им движка. XRumer полезен тем, что находит дополнительные шаблоны URL-адресов на ваших собственных проверенных сайтах, что часто позволяет обнаружить цели, которые пропускают шаблоны URL-адресов по умолчанию.
Чем больше целей, тем больше проверенных ссылок. Воспользуйтесь нашим списком проверенных ссылок для извлечения ссылок или позвольте нам подобрать для вас новые целевые ресурсы.
 English
 简体中文
 Deutsch (Sie)
 Bahasa Indonesia
 Italiano
 日本語
 한국어
 Português do Brasil
 Русский
 Español de México
 ไทย
 Tiếng Việt
 Türkçe